پایان عصر مهندسی انسان؛ با هوش مصنوعی خودبهبودبخش آشنا شوید
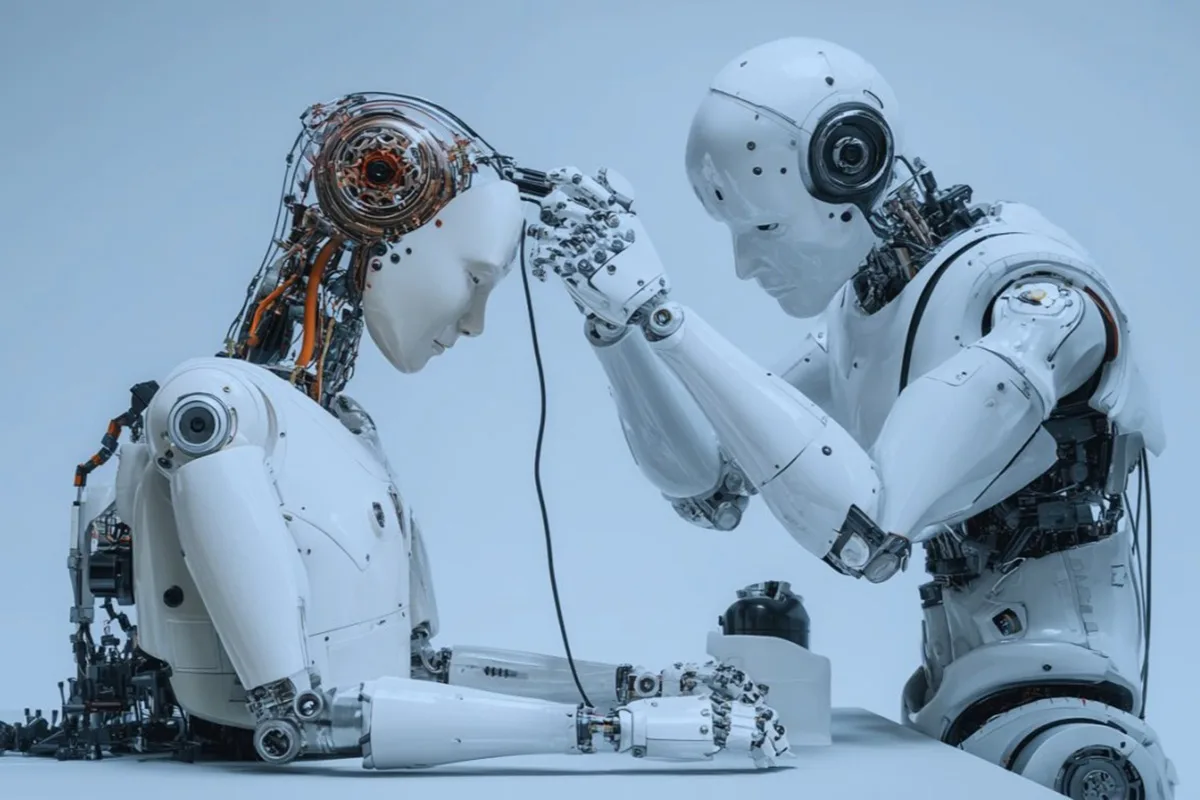
این ایده که ماشین بتواند خودش را ارتقا دهد، به اندازه خود «هوش مصنوعی» قدمت دارد. از همان دهه پنجاه میلادی که یازده دانشمند در کالج «دارتموث» دور هم جمع شدند تا دانش هوش مصنوعی را پایه بگذارند، رؤیای ماشینی در سرشان بود که نسخههای بهتری از خودش بسازد. اما آن زمان نه قدرت پردازشی کافی وجود داشت و نه دادههای عظیم امروزی. مثل این بود که بخواهید با چرتکه و چند ورق کاغذ، نقشه ساخت یک سفینه فضایی را بکشید.
حدود یک دهه بعد «آی. جی. گود»، ریاضیدان برجسته بریتانیایی، پیشبینی عجیبی کرد: «اولین ماشین فوقهوشمند، آخرین اختراعی خواهد بود که انسان نیاز به ساختنش دارد؛ مشروط بر اینکه ماشین آنقدر سربهراه باشد که به ما بگوید چطور تحت کنترل نگهش داریم.» حالا و بعد از گذشت بیش از نیم قرن قطعات پازل «خودبهبودی بازگشتی» بالاخره درحال جفتوجور شدن است.
خودبهبودی بازگشتی چیست؟
غولهای دنیای هوش مصنوعی متوجه شدهاند که استخدام صدها مهندس برای بهینهسازی دستی مدلها به سقف بهرهوری خود نزدیک شده است. گوگل و آنتروپیک میدانند برای رسیدن به جهش بعدی، نیاز به هوشی است که بار تحقیق و توسعه را خودش به دوش بکشد و مفهوم «خودبهبودی بازگشتی» (Recursive Self-Improvement یا به اختصار RSI) از همینجا سرچشمه میگیرد.
تعریف این مفهوم سرراست است: هوش مصنوعی نسلی از نرمافزار را میسازد که از خودش باهوشتر است. سپس نسخه جدید، با تکیه بر ذکاوت بیشترش دستبهکار ساخت نسل بعدی میشود. به زبان سادهتر، سیستمی خلق میشود که مهارت اصلیاش «بهتر شدن» است.
تفاوت هوش مصنوعی خودبهبودبخش با نسل بعدی در چیست؟
مدلهای هوش مصنوعی فعلی مدام درحال یادگیریاند. وقتی دادههای جدیدی به آنها میدهیم، وزنها و پارامترهای داخلیشان را تنظیم میکنند تا جواب بهتری بدهند. این کار مثل دانشآموزی است که برای امتحان ریاضی، مدام تمرین حل میکند تا فرمولها ملکه ذهنش شود.
خودبهبودی بازگشتی اما داستان کاملاً متفاوتی است. اینجا دیگر بحث تمرین بیشتر نیست؛ بحث دست بردن در ساختار مغز است. یعنی هوش مصنوعی بهجای اینکه فقط در چارچوب معماری فعلی بهتر عمل کند، به کدهای پایه و ساختار بنیادین خودش نگاه میکند و میگوید: «اگر این مسیر پردازش داده را تغییر دهم، سیستم کارآمدتری خواهم داشت.»
در این حالت مدل معماری جدیدی ابداع میکند، کدهایش را مینویسد، آن را روی سرورها مستقر میکند و به نسخهای تبدیل میشود که از قبلی باهوشتر است. سپس نسخه جدید، با هوش بیشتر دوباره به ساختار خودش نگاه میکند و ایرادات پیچیدهتری را برطرف میکند. این چرخه همان چیزی است که دانشمندان علوم کامپیوتر را همزمان هیجانزده و میخکوب کرده است.
برای مثال استارتاپ تحت رهبری «جف کلون» (از دانشمندان سابق اوپنایآی و گوگل) بهجای روشهای مرسوم، از رویکرد «محاسبات تکاملی» (Evolutionary Computation) استفاده میکنند که از نظریه تکامل داروین الهام گرفته شده است. در این روش سیستم، دهها معماری مختلف را طراحی میکند، آنها را در بوته آزمایش میگذارد، گزینههای ضعیف را حذف میکند و اجازه میدهد قویترین طرحها برای ساخت نسل بعد با هم ترکیب شوند.
مرز باریک میان دستیار و طراح؛ دادهها چه میگویند؟
برای درک بهتر جایگاهی که امروز در آن ایستادهایم، باید مرز میان «توسعه به کمک هوش مصنوعی» و «توسعه مبتنیبر هوش مصنوعی» را به دقت تفکیک کنیم. امروزه برنامهنویسان زیادی از ابزارهای هوشمند برای تکمیل خودکار کدها استفاده میکنند؛ این حالت صرفاً یک دستیاری ساده است. اما در توسعه مبتنیبر هوش مصنوعی، زنجیرهای شکل میگیرد که گامبهگام استقلال ماشین را افزایش میدهد.
آنتروپیک در مقاله اخیرش با عنوان «وقتی هوش مصنوعی خودش را میسازد»، روند تکامل جالبی را ترسیم کرده است: انسان کد مینویسد، سپس هوش مصنوعی کد پیشنهاد میدهد، بعد هوش مصنوعی خودش فایلها را مینویسد، سپس خودش کدها را بهصورت مستقل اجرا میکند، در مرحله بعد کارها را بین ایجنتهای دیگر تقسیم میکند و درنهایت خودش جانشین خودش را طراحی کرده و آموزش میدهد. مرحله آخر همان نقطه عطف ماجرا یا توسعه خودبهبودبخش است.
براساس آمارهای این مجموعه، تا نیمه سال ۲۰۲۶ حدود ۲۶ درصد از فرایند توسعه مدلهای بعدی آنتروپیک را پیش میبرد و بیش از ۸۰ درصد کدهای جدیدی که به مخزن نرمافزاری آنها اضافه شده، توسط خود «کلاد» نوشته شده است؛ درحالیکه این رقم در اوایل سال ۲۰۲۵ تکرقمی بود.
مهندسان نرمافزار به خوبی میدانند که صرفاً «تعداد خطوط کد» معیار درستی برای بهرهوری نیست؛ همانطور که روزی هزار کلمه نوشتن درباره «جوی مولیان» از کسی «رودکی» نمیسازد. اما نکته مهم این است که هوش مصنوعی حالا توانسته بخش عظیمی از لایه «اجرا و پیادهسازی» را در آزمایشگاههای پیشرو هوش مصنوعی برعهده بگیرد.
یک مثال جذاب دیگر، تلاش کلاد برای بهینهسازی کدهای آموزش یک مدل هوش مصنوعی دیگر است. به این مدل کدهایی دادند تا فرایند آموزش را سریعتر کند. کلاد کد را تغییر میداد، اجرا میکرد، عملکرد را میسنجید، نتایج را تحلیل میکرد و دوباره تغییر دیگری اعمال میکرد. در عرض یک سال ایجنت سرعت کار را تا ۵۲ برابر افزایش داد، درحالیکه مهندسان زبده پس از چندین ساعت کار به بهبود ۴ برابری رسیده بودند. به عبارت دیگر ماشین، درحال پیدا کردن راههایی برای سریعتر کردن ماشینها بود.
معیار مهمتری که توسط مؤسسه ارزیابی مستقل METR بررسی شده، مدتزمانی است که یک سیستم هوشمند میتواند بدون دخالت انسان و با موفقیت به وظایف پیچیده بپردازد. این افق زمانی تقریباً هر چهار ماه یکبار دو برابر شده؛ طوری که از ۴ دقیقه کار در سال ۲۰۲۴ به ۱۲ ساعت کار بیوقفه یک مهندس در سال ۲۰۲۶ رسیده است.
کالبدشکافی حلقه بازگشتی؛ در لایههای زیرین ماشین چه میگذرد؟
خودبهبودی بازگشتی در سه سطح فنی متمایز طبقهبندی میشود:
۱. بهینهسازی فراپارامترها و پایپلاین: سیستم در ابتداییترین سطح سرعت یادگیری، توزیع بار روی پردازندهها و نحوه پاکسازی دادهها را بهصورت پویا تغییر میدهد. این کار بازدهی را بالا میبرد اما ساختار بنیادین مدل را دستنخورده باقی میگذارد.
۲. جستجوی خودکار معماری عصبی (NAS): در این مرحله الگوریتم فراتر از تغییر متغیرهای ساده میرود. هوش مصنوعی توپولوژی شبکههای عصبی، نحوه چینش لایهها و «سازوکار توجه» را از نو میچیند. در واقع ماشین بهجای اینکه فقط کدها را تغییر دهد، معماری را بازطراحی میکند.
۳. بازنویسی خودکار کدهای پایه: این عمیقترین لایه بازگشتی است. در این سناریو که ریشه در مفهوم نظری «ماشین گودل» دارد، مدل به کد منبع، کامپایلر و محیط اجرای خود دسترسی کامل دارد. سیستم کدهای اجرایی خود را بازبینی میکند، توابع ناکارآمد را دور میریزد، الگوریتمهای بهینهسازی جدید ابداع میکند و با اجرای آزمایشهای موازی، اعتبار کدهای جدید را پیش از جایگزینی نهایی میسنجد.
یکی از نمونههای بارز این فرایند در سالهای اخیر، آزمایش «ماشین داروین-گودل» (Darwin Gödel Machine) بود. پژوهشگران یک عامل هوشمند کدنویسی را در محیطی ایزوله قرار دادند که اجازه داشت به دفعات، اسکریپتهای پایه و منطق تصمیمگیری خودش را ویرایش و بازنویسی کند.
این مدل بدون اینکه داده آموزشی جدیدی دریافت کند یا معماری زیربناییاش تغییر کند، صرفاً با بازنویسی روش حل مسئله و پاکسازی کدهای خود، چالشهای استاندارد برنامهنویسی را تا ۲.۵ برابر بهتر حل کرد.
شکستن بنبست داده با کمک الگوریتمها
شاید این سؤال در ذهنتان شکل گرفته که اگر هوش مصنوعی تمام متون نوشتهشده توسط بشر را خوانده باشد، برای جهش بعدی دادههایش را از کجا میآورد؟ پاسخ در مفهومی نهفته که به آن «بوتاسترپینگ» (Bootstrapping) یا خودراهاندازی دادهها میگویند؛ یعنی توانایی ماشین در تبدیل شدن به آموزگار و منتقد خودش.
روشهایی نظیر «استدلالگر خودآموخته» (STaR) نمونهای مدرن از این دستاورد هستند:
- تولید مسیرهای فکری: مدل با چندین زنجیره منطقی مختلف تلاش میکند یک مسئله پیچیده ریاضی یا برنامهنویسی را حل کند.
- اعتبارسنجی با محیط خارجی: از آنجا که درستی کد نرمافزاری یا پاسخ یک معادله ریاضی را میتوان با ابزارهای قطعی (مانند مفسر پایتون یا کامپایلر) سنجید، سیستم متوجه میشود کدام مسیر فکری به جواب درست رسیده است.
- آموزش روی راهحلهای خود: مدل زنجیرههای فکری اشتباه را دور میریزد و مسیرهای موفق تولیدشده توسط خودش را بهعنوان داده آموزشی باکیفیت به لایههای عصبی تزریق میکند.
بدین ترتیب نیاز به انسان برای برچسبگذاری یا تولید دادههای آموزشی جدید به حداقل میرسد. مدل در یک حلقه بسته و پیوسته، خودش مسئله طراحی میکند، به آنها پاسخ میدهد، پاسخها را میآزماید و با همین روش پیش میرود.
گلوگاهی به نام «سلیقه پژوهشی»؛ حلقهای که هنوز کامل نیست
با وجود این دستاوردهای چشمگیر، هنوز یک سنگر مهم برای آدمیزاد باقی مانده است. فرض کنید هوش مصنوعی میتواند هر کدی را بنویسد و هر آزمایشی را با بالاترین سرعت اجرا کند. اما سؤال اساسی اینجاست: «اصلاً چه آزمایشی باید انجام شود؟»
توسعه هوش مصنوعی مانند ساختن یک ساختمان بزرگ است که چندین مرحله متمایز دارد:
1. اجرای وظایف روتین: نوشتن اسکریپتها و توابع مشخص.
2. حل مسئله: پیدا کردن باگها و رفع خطاهای سیستمی.
3. آزمایشگری: اجرای تستها و ثبت دادهها.
4. طراحی آزمایش: تعیین اینکه کدام متغیرها ارزش بررسی دارند.
5. بینش و جهتدهی علمی: تشخیص اینکه در میان هزاران مسئله موجود، پرداختن به کدام پرسش بنیادیترین تغییر را ایجاد میکند و کدام مسیر به بنبست ختم میشود.
مدلهای فعلی در چهار لایه اول عملکردی خیرهکننده از خود نشان میدهند؛ اما گلوگاه اصلی همچنان در لایه پنجم یا همان «ذائقه و شهود پژوهشی» باقی مانده است. «مارک چن»، مدیر ارشد تحقیقات OpenAI، به درستی اشاره میکند که مدلهای کنونی میتوانند میلیونها سطر کد تولید کنند، اما هنوز فاقد بینش، اولویتسنجی، سلیقه و خلاقیت ساختارشکنانه پژوهشگران باتجربه هستند. هوش مصنوعی میتواند بهینهترین مسیر را در هزارتویی که ما برایش کشیدهایم پیدا کند، اما هنوز نمیداند چه زمانی باید کلاً آن هزارتو را رها کرد و دیوارهای جدیدی ساخت.
قانون امدال؛ آیا فردا صبح رباتها دنیا را میگیرند؟
اما چه میشود اگر روزی هوش مصنوعی آنقدر پیشرفت کند که سلیقه پژوهشی را هم یاد بگیرد؟ چه میشود اگر بتواند مسیرهای تحقیقاتی را خودش انتخاب کند و نسخههای بعدیاش را بدون نیاز به ما بسازد؟
نگرانی اصلی محققان در این سناریو این است که اهداف هوش مصنوعی با منافع بشر در تضاد باشد. شاید این نگرانی تا حد زیادی بهجا باشد اما محدودیتهای دنیای فیزیکی و اصلی بنیادی در علوم کامپیوتر به نام «قانون امدال» (Amdahl’s law) در آن نادیده گرفته شده است. این قانون میگوید اگر شما فقط بخشی از یک سیستم بزرگ را بینهایت سریع کنید، کل سیستم به همان نسبت سریع نمیشود، چون بقیه بخشها با سرعت قبلی کار میکنند.
حتی اگر روزی هوش مصنوعی خودبهبودبخش با سرعت برقوباد کدهای خود را بازنویسی کرده و معماریهای نوین کشف کند، توسعه فناوری درنهایت به موانع جهان مادی برخورد میکند:
- زیرساخت فیزیکی: کارخانههای ساخت تراشه (فابها) نمیتوانند با یک دستور نرمافزاری ظرفیت تولید خود را هزار برابر کنند؛ ساخت یک سایت جدید سالها زمان میبرد.
- انرژی و شبکه: مصرف برق دیتاسنترها و محدودیتهای انتقال جریان در نیروگاهها موانعی کاملاً فیزیکی و ملموس هستند.
- آزمایشهای زیستی: کشف فرمول یک داروی جدید شاید چند ثانیه طول بکشد، اما تست اثربخشی آن روی بافت سلولی و طی مراحل بالینی در بدن انسان نیازمند گذر ماهها و سالها زمان است.
- بوروکراسی اداری: نهادهای سیاسی، مراجع قانونگذاری، زنجیره تأمین جهانی و حتی روابط اجتماعی آدمها بسیار کندتر از پردازشگرهای سیلیکونی تغییر میکنند.
بنابراین حلقه خودبهبودی قرار نیست مانند داستانهای علمیتخیلی، یک شبه پایههای زمین را زیر و رو کند و به دیوار سخت محدودیتهای فیزیکی برخورد میکند.
در آخر
هوش مصنوعی درحال اجرای بخش قابلتوجهی از تحقیقات برای ساخت نسل بعدی خودش است؛ اما هنوز نمیتواند به تنهایی این تحقیقات را «هدایت» کند. اگر روزی ماشین بتواند خودش تصمیم بگیرد کدام آجر را کجا بگذارد و چرا؛ ممکن است آخرین سد راه هوش مصنوعی شکسته شود.
آن زمان ما با چرخهای روبهرو خواهیم شد که دیگر سرعت توسعه فناوری به تعداد پژوهشگران و مهندسان انسانی بستگی نخواهد داشت و تنها محدودیت باقیمانده برای بناگذاشتن تمدن جدید تعداد کارتهای گرافیک و جریان برقی است که به دیتاسنترها سرازیر میشود.


